Azure OpenAI 비용 줄이는 세 가지 — 프롬프트 캐싱, Batch, PTU 고르는 기준
같은 모델이라도 배포 방식과 호출 방식에 따라 비용이 크게 달라진다. 프롬프트 캐싱·Global Batch·PTU를 언제 쓰는지 Foundry 포털의 실제 화면과 공식 문서 기준으로 정리했다.
결론부터. 시작은 Global Standard(종량제) 로 하고, 그다음에 줄일 곳을 순서대로 본다.
- 매번 같은 긴 앞부분(시스템 프롬프트, 문서)을 보낸다 → 프롬프트 캐싱
- 결과가 당장 필요 없다(야간 요약, 대량 분류) → Global Batch, 50% 저렴
- 트래픽이 크고 꾸준하며 지연 시간이 중요하다 → PTU + 예약
Microsoft 문서도 “대부분의 워크로드는 Global Standard로 시작하라. 가장 먼저 출시되고 가장 싸다”고 권한다(Deployment types).
내 배포부터 확인
Foundry 포털 모델 → 배포에서 ① 배포 유형이 보인다. 내 프로젝트는 전부 “글로벌 표준” 또는 “표준”이었다. ② PTU 계산기와 ③ 일괄 작업(Batch) 메뉴도 같은 화면에 있다.
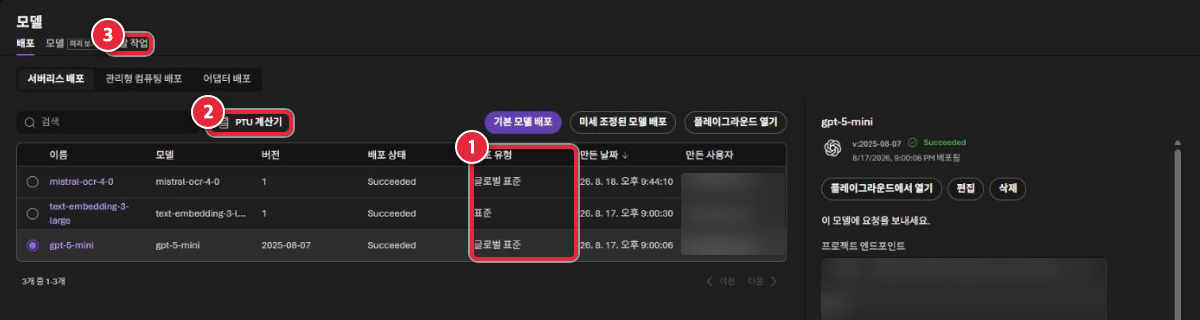 ① 배포 유형 ② PTU 계산기 ③ 일괄 작업. 사용자·엔드포인트·키는 가렸다
모델 카탈로그의 배포 SKU 필터를 펼치면 ① 고를 수 있는 배포 방식이 다 나온다. 전역/데이터 영역/지역 × 표준/일괄 처리/프로비전드 조합이다. 데이터 영역(Data Zone)은 데이터를 US·EU·APAC 같은 구역 안에서만 처리할 때 쓴다.
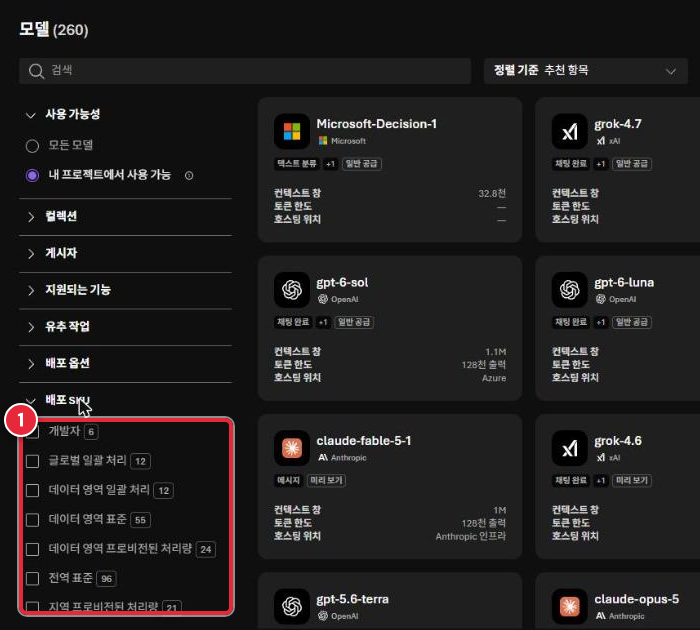 ① 배포 SKU 종류와 해당 모델 수
1. 프롬프트 캐싱
매 요청마다 똑같은 긴 앞부분을 보낸다면, 그 부분의 계산을 캐시해 두고 재사용한다. 문서 기준 조건과 효과는 이렇다(Prompt caching).
- 프롬프트가 최소 1,024토큰이고, 앞 1,024토큰이 완전히 같아야 한다. 한 글자만 달라도 캐시 미스
- 캐시 읽기는 Standard 배포에서 입력 단가 할인, Provisioned 배포에선 입력 토큰 최대 100% 할인
- 캐시는 보통 5~10분 쓰지 않으면 비워지고, 마지막 사용 후 1시간 안에는 반드시 지워진다
- 새로 알게 된 점: GPT‑5.6 이후 모델은 캐시 쓰기에 요금이 붙을 수 있다. 그리고
explicit모드에서는 명시한 breakpoint가 없으면 캐싱을 아예 쓰지 않는다. 기본값(implicit)은 마지막 메시지에 자동으로 breakpoint를 둔다
실무 요령은 하나다. 바뀌지 않는 것(지침, 규정 문서, 예시)을 앞에, 바뀌는 것(사용자 질문)을 뒤에 둔다. 앞에 날짜나 사용자 이름을 넣으면 캐시가 매번 깨진다.
2. Global Batch — 50% 저렴, 대신 기다린다
Batch API는 요청을 한 파일(.jsonl)에 모아 보내고 24시간 안 처리를 목표로 하는 대신 Global Standard보다 50% 싸다. 할당량도 따로라서 온라인 서비스 트래픽을 잡아먹지 않는다(Batch).
포털에서 일괄 작업 만들기를 누르면 ① 200MB 미만 .jsonl 파일을 올리는 칸과 ② 완료 창 24시간 안내가 보인다. 24시간이 넘어도 작업이 만료되지는 않고, 취소하면 이미 끝난 것만 돌려받고 그만큼만 청구된다.
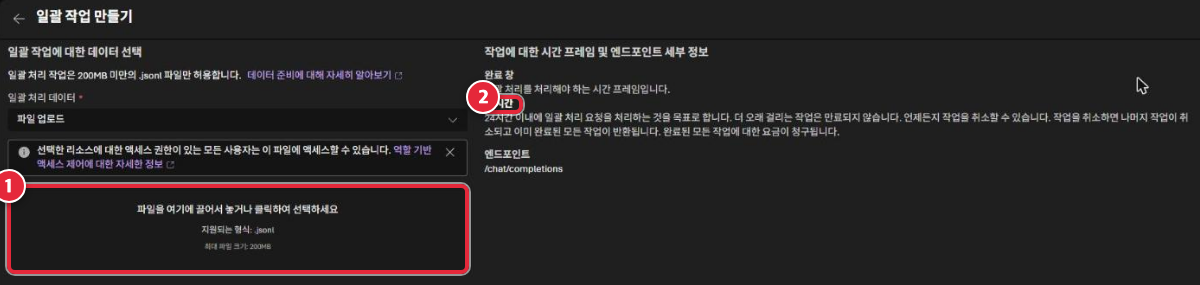 ① .jsonl 업로드 ② 24시간 완료 창
야간에 쌓인 상담 기록 요약, 문서 수천 건 분류, 평가 데이터 생성처럼 사람이 기다리지 않는 일이면 Batch가 거의 항상 답이다.
3. PTU — 용량을 빌리는 방식
PTU(Provisioned Throughput Unit)는 토큰이 아니라 처리 용량을 시간 단위로 빌리는 것이다. 요청이 없어도 배포해 둔 PTU만큼 시간당 요금이 나간다. 대신 오래 쓸 거면 Azure 예약으로 할인받는다(PTU billing).
PTU 계산기에 예시 워크로드를 넣어 봤다(분당 300요청, 입력 3,000·출력 500토큰, 캐시 적중 50%). ① 입력하면 ② 필요한 PTU와 기간별 가격이 나온다.
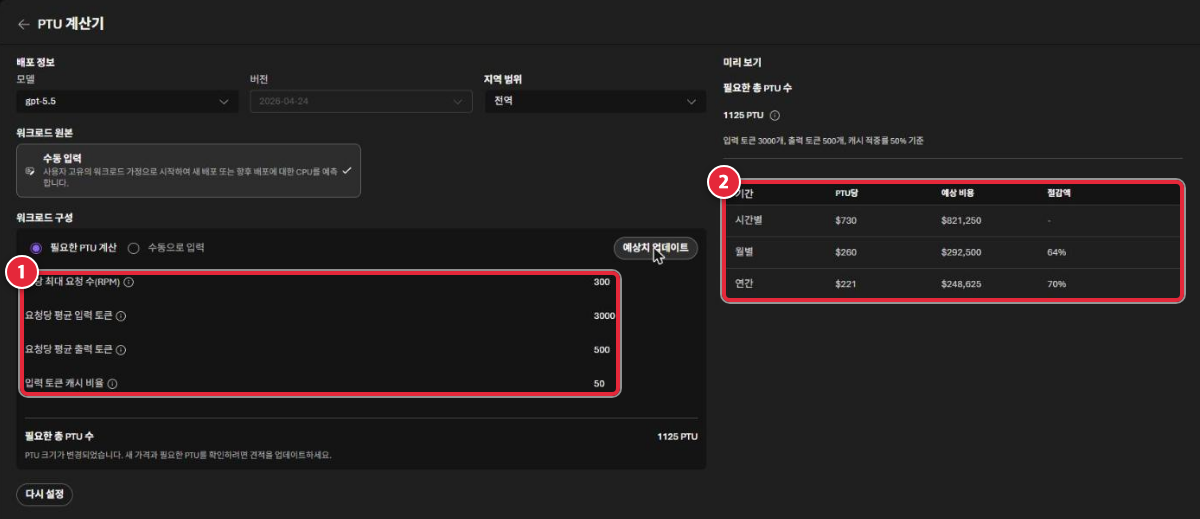 ① 워크로드 입력 ② 필요 PTU와 시간별·월별·연간 가격 (gpt‑5.5, 포털 표시값 기준)
이 예시에선 1,125 PTU가 필요했고, PTU당 가격이 시간 단위 $730 → 월 예약 $260(64% 절감) → 연 예약 $221(70% 절감)으로 표시됐다. 숫자 자체보다 “꾸준히 쓸 거면 예약 없이 PTU를 쓰는 건 손해” 라는 감이 중요하다. 캐시 적중률을 입력하는 칸이 있다는 것도 눈여겨볼 점이다. 캐싱이 PTU 수요까지 줄여 준다.
마지막 안전장치: 예산 알림
어떤 방식을 쓰든 Cost Management의 예산(Budget) 은 먼저 걸어 두자. 만들기 화면에서 ① 기간(월별)과 금액을 정하면 ② 최근 비용과 예측이 그래프로 보이고, 다음 단계에서 80%·100% 같은 알림을 메일로 받을 수 있다(Create budgets).
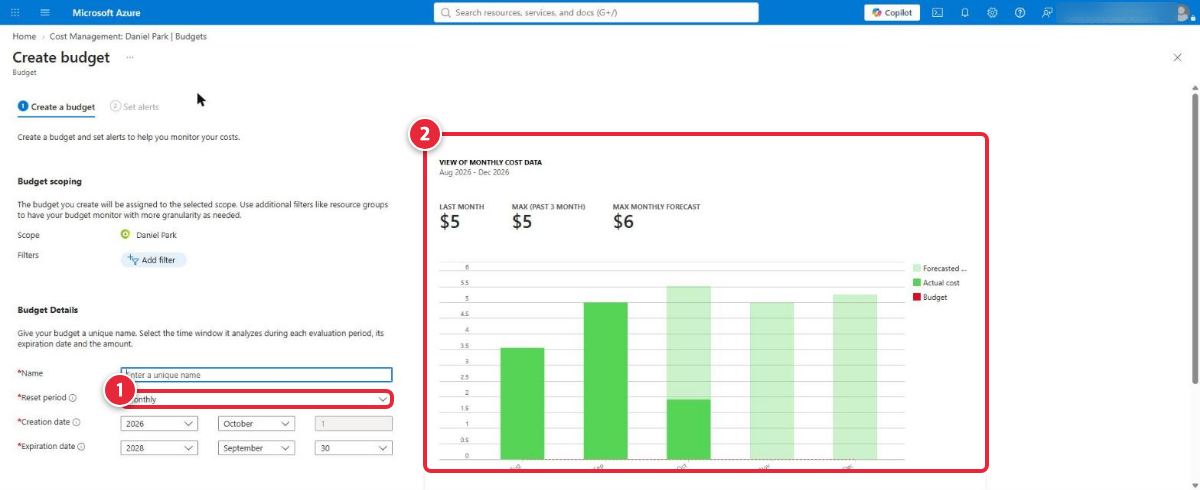 ① 재설정 주기 ② 최근 비용·예측 그래프. 계정 정보는 가렸다
예산은 알림일 뿐 자동으로 리소스를 멈추지 않는다. 실습용 구독이라도 실습 후엔 배포·에이전트·업로드 파일을 직접 지워야 한다.
써 보고 든 생각
- 고객사 PoC에서 비용 이야기가 나오면 대부분 “모델을 작은 걸로 바꾸자”부터 나온다. 그 전에 캐싱이 되는 프롬프트 구조인지, Batch로 돌릴 수 있는 일인지를 먼저 보는 게 효과가 크다
- 이번에 문서를 다시 읽으며 캐싱 규칙(explicit/implicit, GPT‑5.6 이후 캐시 쓰기 요금)이 바뀐 걸 알았다. 비용 규칙은 자주 바뀌니 견적 전에 문서 날짜를 꼭 확인하자
참고
- Deployment types — Microsoft Foundry
- Prompt caching with Azure OpenAI
- Azure OpenAI Batch
- Provisioned throughput billing and cost management
- Tutorial: Create and manage budgets
- PTU 가격은 2026-10-11 Foundry 포털 PTU 계산기 표시값이다. 지역·모델·시점에 따라 다르다